Dieses Blog berichtet über KI im Campus-Management. Dazu gehört auch die Frage, wo KI an ihre Grenzen stößt – und wo bewährte Regeln die bessere Lösung sind. Denn hinter dem Glanz der neuen Technologien lauert eine unbequeme Frage: Für viele Kernprozesse an Hochschulen ist klassische algorithmische Intelligenz nicht nur ausreichend — sie ist schlicht besser.
Mit algorithmischer Intelligenz meinen wir hier deterministische, regelbasierte Verfahren: Eine eindeutig definierte Eingabe wird nach expliziten Regeln verarbeitet und führt reproduzierbar zu einem eindeutig bestimmten Ergebnis. Lernende KI-Systeme leiten ihre Ergebnisse dagegen aus Mustern in Trainingsdaten ab, arbeiten probabilistisch mit einem wahrscheinlichen Ergebnis.
Welche Art von Intelligenz passt zu welchem hochschulischen Problem?
Wenn der Nagel zur Schraube wird
„Wir lösen die Probleme mit KI“ verspricht manch ein Startup. Das klingt modern, fortschrittlich, zukunftsfähig. Kein Wunder, dass KI in Hochschulstrategien und IT-Roadmaps immer häufiger auftaucht. Aber wie so oft ist die Realität komplexer und nach der Spitze der überhöhten Erwartung an KI und dem Tal der Ernüchterung kommt das Plateau der Produktivität. Und auf dem Plateau wird klar, welche Art von Problemen mit Sprachmodellen gelöst werden können und welche sich besser mit algorithmischer Regel-Intelligenz (kurz: Algorithmen) lösen lassen.
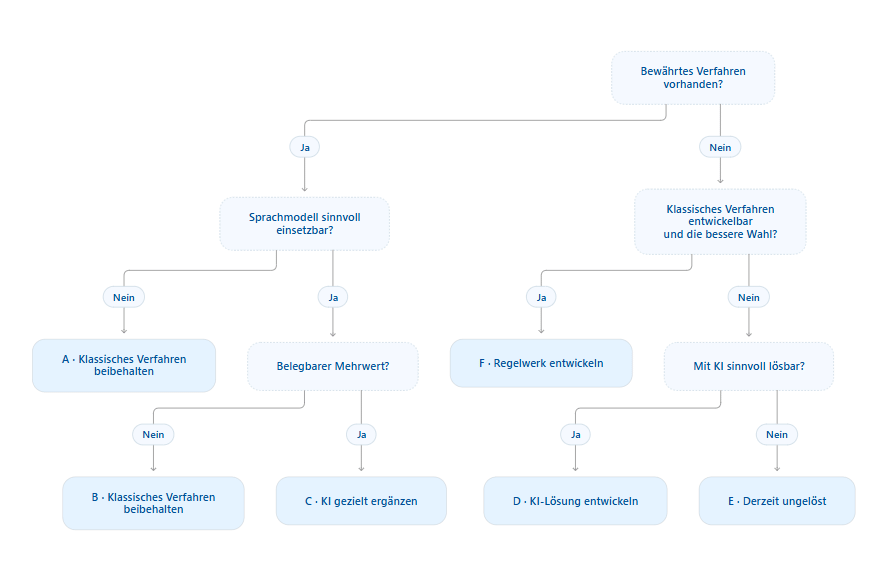
5 grobe Fälle kann man unterscheiden:
A) Probleme, die bereits mit Algorithmen gelöst werden und die Sprachmodelle NICHT lösen könnten (Regelaufgabe, klassisch)
B) Probleme, die bereits mit Algorithmen gelöst werden und die Sprachmodelle NICHT besser lösen könnten (Regelaufgabe, vorteilhaft)
C) Probleme, die bereits mit Algorithmen gelöst werden und die Sprachmodelle besser lösen könnten (Regel-zu-KI-Aufgaben, Mehrwert)
D) Probleme, die NICHT mit Algorithmen gelöst werden können und die Sprachmodelle lösen könnten (KI-Aufgabe, neu)
E) Probleme, die NICHT mit Algorithmen gelöst werden können und die Sprachmodelle auch NICHT lösen könnten
Etablierte Campus-Management-Systeme haben für A und B längst praxiserprobte Lösungen. Spannend wird KI für sie vor allem bei C und D. Manche Startups werben dagegen mit „Wir machen das mit KI“. Das kann doppelt irreführend sein: Nicht jede Aufgabe wird durch KI besser gelöst. Und manchmal heißt „mit KI“ nur, dass jemand das klassische Regelwerk per Vibe Coding programmieren lässt.
Eine Entscheidungslogik für die Einführung von KI-Problemlösungen könnte sein: Gibt es schon ein Regelwerk, das die Aufgabe zuverlässig erfüllt? Dann braucht es einen konkreten Verbesserungsbedarf, bevor ein Sprachmodell überhaupt als Ersatz infrage kommt. Gibt es noch keine Lösung, sollte man zuerst prüfen, ob sich ein klares Regelwerk entwickeln lässt. Erst wenn die Aufgabe offene Sprache, unstrukturierte Informationen oder schwer formulierbare Muster umfasst, wird ein lernendes Modell besonders interessant. Und auch dann muss sein Nutzen am konkreten Ergebnis gemessen werden.
Anders gesagt: KI im Sinne von Machine Learning und tiefen neuronalen Netzen ist ein mächtiges Werkzeug für Probleme, bei denen Muster in großen Datenmengen erkannt, Sprache verstanden oder komplexe Zusammenhänge approximiert werden müssen. Aber nicht jedes Problem ist ein KI-Problem. Und nicht jede „clevere“ Lösung muss eine lernende KI-Lösung sein. Nein, ein bewährtes Regelwerk kann die bessere Lösung sein: einfacher, nachvollziehbarer und verlässlicher. Wo noch kein Regelwerk existiert, lohnt es sich sogar zu prüfen, ob sich eines entwickeln lässt – bevor man ein Sprachmodell einsetzt.
Beispiel 1: Durchschnittsnote berechnen
Eine gewichtete Durchschnittsnote nach Prüfungsordnung ist ein mathematisch vollständig definiertes Problem. Gewichtungen, Rundung und Bestehensgrenzen sind festgelegt. Das Ergebnis lässt sich mit einem Rechenverfahren exakt und reproduzierbar bestimmen. Es gibt genau eine richtige Antwort — und die lässt sich mit einem algebraischen Verfahren exakt berechnen.
Würde man hier ein KI-Modell einsetzen, das aus vergangenen Notenvergaben „lernt“, wäre das nicht nur unnötig aufwändig. Es wäre schlicht falsch: Ein Modell würde Rauschen in die Berechnung einführen, wo mathematische Exaktheit gefordert ist. Die Note 2,3 nach Prüfungsordnung ist 2,3 — kein Näherungswert, keine Approximation. Ganz abgesehen davon, dass man für eine neue Prüfungsordnung mit neuer Notenberechnung erstmal eine große Menge an Trainingsdaten erzeugen müsste.
Systeme wie TraiNex setzen hier bewusst auf algorithmische Intelligenz: Die Prüfungsordnungsregeln werden exakt codiert, die Berechnung ist deterministisch und jederzeit vollständig nachvollziehbar. Neue Prüfungsordnungsregeln können schnell integriert werden. Für Prüfungsämter und akkreditierende Stellen ist Nachvollziehbarkeit keine Option — sie ist Pflicht.
Beispiel 2: Studienabbruch frühzeitig erkennen
Frühwarnsysteme für Studienabbruchrisiken sind ein beliebtes Einsatzfeld für KI. Ein Modell könnte Prüfungsergebnisse, Anwesenheiten und weitere Daten auswerten, um eine Risikoeinschätzung abzugeben.
Vorher muss jedoch klar sein, welche Aufgabe das System erfüllen soll. Geht es darum, nach festgelegten Kriterien einen Anlass für ein Unterstützungsangebot zu erkennen? Ein regelbasiertes Warnsystem kann hier die überlegene Lösung sein: Wenn ein Studierender drei Prüfungen nicht bestanden hat und gleichzeitig die Anwesenheitsquote unter 50 % fällt, wird ein Hinweis ausgelöst — transparent, nachvollziehbar, erklärbar. Die Regel ist bekannt, kann von der Hochschule selbst definiert werden, und ihre Anwendung ist vollständig dokumentierbar.
Geht es dagegen darum, künftige Studienabbrüche möglichst gut vorherzusagen, ist das eine andere Aufgabe. KI-Prognosemodelle können besser sein, da es um sich ändernde Muster in Datenmengen geht. Warum aber das Modell einen Studierenden als „Abbruchrisiko“ markiert hat, lässt sich nicht ohne Weiteres erklären — und das ist datenschutzrechtlich und ethisch heikel. Gerade bei personenbezogenen Risikoprognosen steigen die Anforderungen an Transparenz, Nachvollziehbarkeit und Datenschutz.
Beispiel 3: Zulassungsvoraussetzungen prüfen
Darf sich dieser Studierende zu dieser Prüfung anmelden? Hat er die Vorleistungen erbracht, ist er im richtigen Semester, liegen alle notwendigen Studienleistungen vor? Auch das ist kein KI-Problem. Es ist ein Regelprüfungsproblem.
Die Zulassungsvoraussetzungen sind in der Prüfungsordnung exakt definiert — und ein Algorithmus kann diese Regeln sekündlich auf Tausende Anmeldungen anwenden. Zulassungsregeln werden konfiguriert, pro Studienrichtung oder Bundesland, jede Anmeldung wird dagegen geprüft, Ablehnungen werden mit Begründung kommuniziert. Bei Fehlern kann das Regelwerk schnell und sicher angepasst werden.
Ein ML-Modell, das aus vergangenen Zulassungsentscheidungen „lernt“, würde hier nicht nur unnötige Komplexität einführen, und damit verbunden einen unnötigen Energieverbrauch und unnötige Kosten. Es würde die Gefahr mitbringen, historische Ungerechtigkeiten zu reproduzieren oder falsche Entscheidungen zu treffen, die nicht erklärbar und u.U. rechtlich nicht haltbar sind.
Interessant ist dabei auch die regulatorische Perspektive: Der EU AI Act stuft bestimmte KI-Systeme im Bildungsbereich als Hochrisiko-Systeme ein — unter anderem dann, wenn sie über Zugang oder Zulassung entscheiden oder Lernergebnisse bewerten. Wo eine Prüfungsordnung bereits eindeutige Regeln vorgibt, kann ein deterministischer Algorithmus nicht nur einfacher und genauer, sondern auch regulatorisch wesentlich unproblematischer sein.
Die richtige Technologie für das richtige Problem
Der Fehler liegt nicht im Einsatz von KI — er liegt im undifferenzierten Einsatz. KI ist mächtig, wenn Trainingsdaten vorliegen, wenn Muster erkannt werden sollen, die für Menschen nicht erfassbar sind, wenn Sprache verstanden oder wenn große unstrukturierte Datenmengen ausgewertet werden sollen.
Klassische Algorithmen sind überlegen, wenn das Problem mathematisch vollständig definiert ist, wenn Exaktheit gefordert ist, wenn Nachvollziehbarkeit rechtlich oder ethisch notwendig ist — und wenn Datenschutz sowie Transparenz im Vordergrund stehen.
Für Campus-Management-Systeme bedeutet das: Notenberechnung und die Anwendung eindeutig festgelegter Zulassungsregeln gehören in die Hände regelbasierter Verfahren. Ein Frühwarnhinweis nach festgelegten Kriterien kann ebenfalls so umgesetzt werden. KI kann ergänzen, wo sie einen belegbaren Vorteil bringt — etwa beim Verstehen frei formulierter Beratungsanfragen oder in einem individuellen Lerndialog. Und für all die Probleme, wo bewährte regelbasierte Verfahren keine gute Lösung bringen, sollte der Einsatz von Sprachmodellen angedacht werden.
Dieses kategorielle Denken kann bei der Entscheidung für oder gegen KI helfen. Als Profi sollte man die Kategorien dann aber wieder verbinden, denn mittelfristig dürfte die Kombination aus Regelwerk und Sprachmodell besonders erfolgversprechend sein. So nutzt die SMARTA-Architektur den „Algorithmic Prompt Composer (APC)“, der regelbasiert mit Datenbankzugriff ein Sprachmodell ansteuert und dessen Antwort danach regelbasiert verarbeitet. Auch sind klassische Schleifen mit Abbruchbedingungen ein gutes Gerüst, um KI-Agenten am Laufen zu halten.
Fazit: Nicht die neueste Technologie — die richtige
Die Frage ist nicht, ob man KI einsetzt. Die Frage ist, wo sie wirklich hilft — und wo ein vorhandenes oder neu entwickeltes Regelwerk die bessere Lösung ist, oder ob KI mehr Risiko als Nutzen bringt. Hochschulen, die diesen Unterschied kennen, treffen bessere Technologieentscheidungen. Und bauen Systeme, denen Studierende, Lehrende und Akkreditierer vertrauen können.
Wenn eine Regel reicht, braucht es kein Sprachmodell. Wenn Regeln an ihre Grenzen stoßen, kann KI ihre Stärke zeigen. Modern ist nicht, überall KI einzubauen. Modern ist, das Problem richtig zu lösen. Mal mit KI, mal ohne KI, mal in Kombi mit einer Regel. Und nur wer die Welt der regelbasierten Algorithmen kennt, kann die Probleme einer Hochschule auch mit KI sinnvoll lösen.