Intellektuelle Souveränität: Was der Wissenschaftsrat fordert – und was wir bereits entwickeln

Am 6. Juli 2026 veröffentlichte der Wissenschaftsrat seine Empfehlungen „Intellektuelle Souveränität: Empfehlungen für die Hochschulbildung in Zeiten generativer KI“ — neun konkrete Forderungen an Hochschulen, Lehrende, Studierende, Länder und Bund. Beim Lesen hatten wir mehrfach denselben Gedanken: Genau dafür entwickeln wir TraiNex und SMARTA.
Intellektuelle Souveränität und Generative KI – Wissenschaftsrat Empfehlungen 2026
Intellektuelle Souveränität vs. Generative KI — zum Vergrößern anklicken

Was der Wissenschaftsrat fordert

„Kritisches Denken lässt sich nicht an eine KI delegieren“, sagt WR-Vorsitzender Wolfgang Wick. Diese Aussage ist keine KI-Skepsis — sie ist eine Präzisierung: KI soll gezielt eingesetzt werden, nicht unkontrolliert. Der Wissenschaftsrat fordert Hochschulen auf, sowohl KI-Kompetenzen aufzubauen als auch KI-freie Räume im Curriculum zu verankern. Prüfungsformate sollen überdacht, Hochschulen als soziale Lernorte erhalten werden. Und: Souveräne KI-Infrastrukturen sollen entstehen, die langfristig finanziert und hochschulübergreifend nutzbar sind.

Nicht möglichst viel KI — sondern die richtige KI

Nicht möglichst viel KI, sondern KI gezielt und kontrolliert — mit dem richtigen Kontext, für Lehrende, Studierende und die Hochschulverwaltung. Für uns heißt das: Context Engineering voranzutreiben, also die intelligente Verbindung von KI mit dem individuellen Nutzer und dessen aktueller Situation. Automatische Berücksichtigung von Studienverläufen, Lehrplänen, Prüfungsordnungen, dem Stundenplan oder konkret der heutigen Vorlesung und dem Lernskript. Dazu verbinden wir generative KI mit unserer algorithmischen Intelligenz, gesteuert durch Agenten.

Context Engineering als Antwort

Eine KI, die automatisch den Studienstand, den Lehrplan, die Prüfungsordnung und den Inhalt der heutigen Vorlesung berücksichtigt, ist keine unkontrollierte Black Box — sie ist ein präzises Werkzeug mit definiertem Kontext. Das ist der Kern von SMARTA: Nicht generative KI, die einfach antwortet, sondern KI, die den richtigen Kontext aus dem Campus-Management-System bezieht. Studienverläufe, Lehrpläne, Prüfungsordnungen, Stundenplan, das Lernskript der heutigen Vorlesung — all das bildet den Rahmen, innerhalb dessen die KI agiert.

Fazit

Der Wissenschaftsrat hat einen wichtigen Orientierungsrahmen gesetzt. Für Hochschulen, die KI nicht einfach „einführen“ wollen, sondern gezielt einsetzen möchten — mit Kontrolle, Kontext und Kompetenz — zeigt TraiNex, wie das konkret aussehen kann.
→ Zur vollständigen Pressemitteilung des Wissenschaftsrats

Erkennt KI Gefühle? Empirische Qualitätsbewertung der Sentiment-Analyse im SMARTA-Projekt

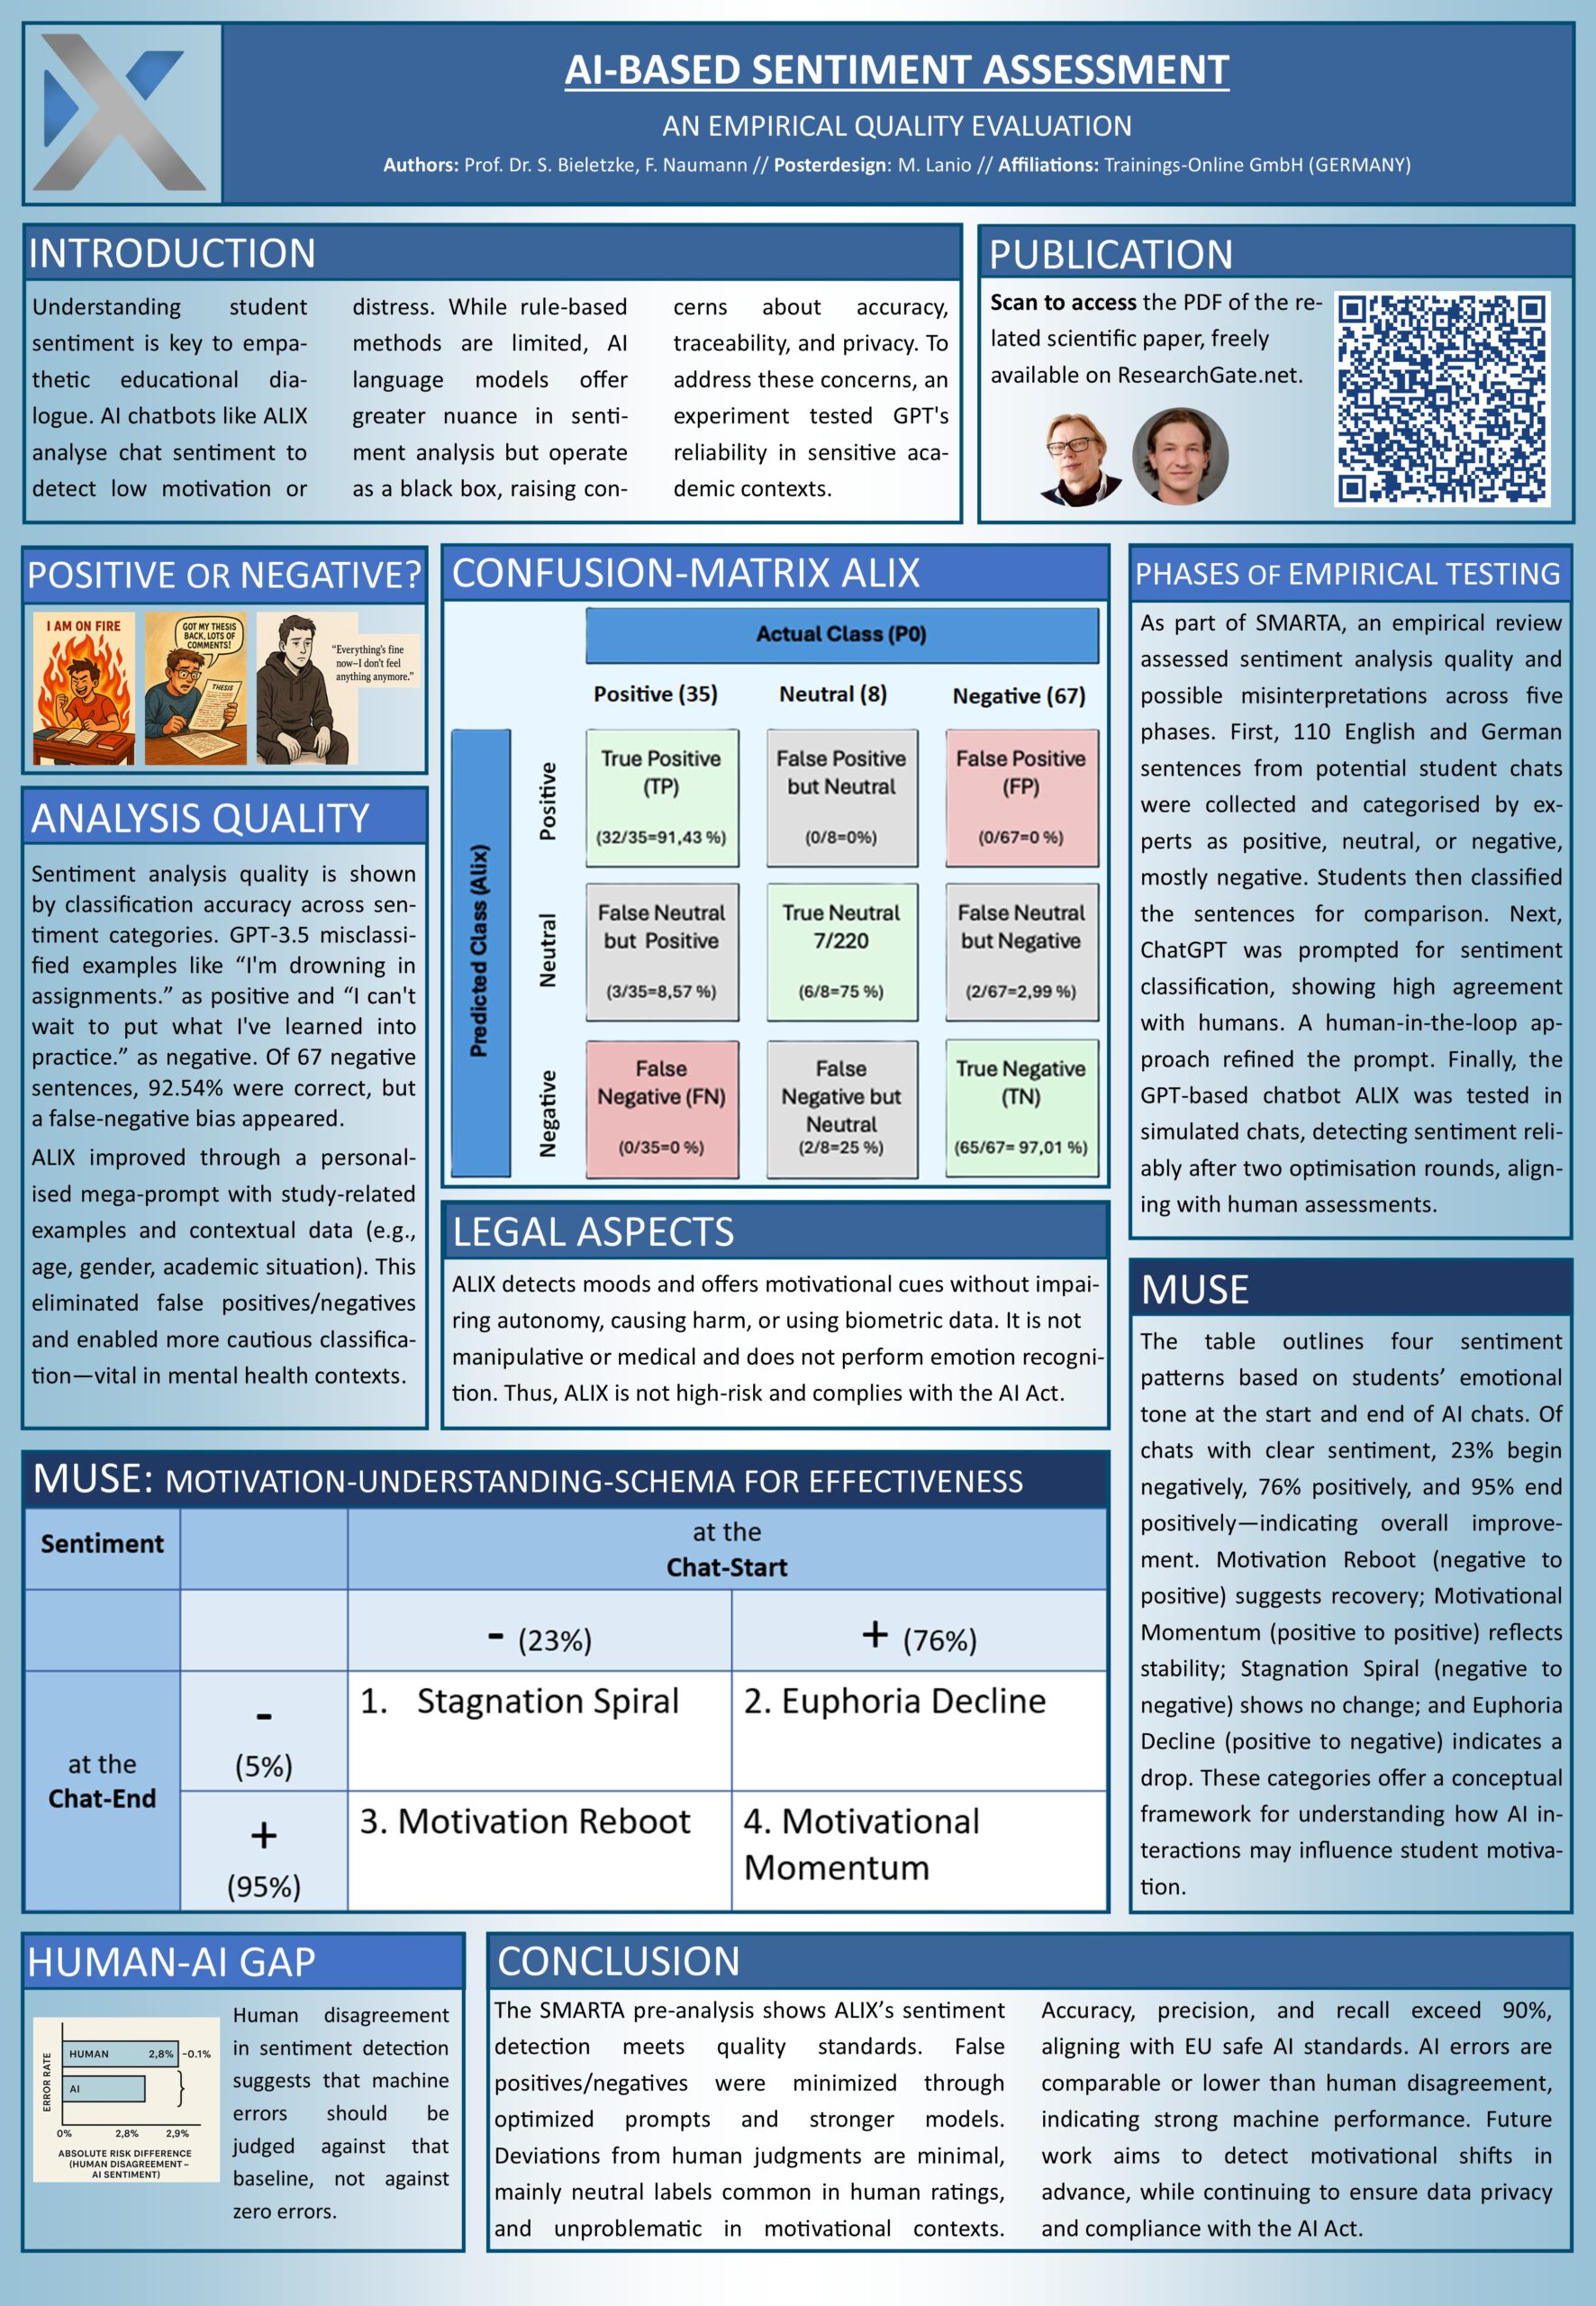
Kann eine KI zuverlässig erkennen, ob ein Studierender frustriert, motiviert oder gleichgültig ist? Diese Frage stand im Mittelpunkt unserer empirischen Studie, die wir im Juli 2025 auf der EDULEARN-Konferenz in Palma de Mallorca vorgestellt haben.

Sentiment-Analyse Poster – SMARTA Projekt EDULEARN 2025
Sentiment-Analyse: KI vs. Mensch — zum Vergrößern anklicken

Sentiment-Analyse als Kernkomponente von SMARTA

Im SMARTA-Projekt entwickeln wir KI-gestützte Chatbots, die Studierende bei Motivation, Lernorganisation und persönlichen Herausforderungen begleiten. Damit die Chatbots einfühlsam reagieren können — auf Prokrastination, sozialen Druck oder Frustration — müssen sie den emotionalen Ton der Konversation präzise erfassen. Dafür setzen wir automatisierte Sentiment-Analyse ein.

Was die Studie untersucht hat

In einem Vergleichstest haben wir Sentiment-Klassifikationen von Sprachexperten, Studierenden und verschiedenen GPT-Modellen (GPT-3.5 und neuere Versionen) gegenübergestellt: wie gut erkennen die Modelle positive, negative und neutrale Aussagen? Qualitätsmetriken: Accuracy, Precision, Recall und Konfusionsmatrizen.

Das Ergebnis: GPT ist zuverlässiger als erwartet

Selbst ältere Modelle wie GPT-3.5 erkennen Sentiment mit hoher Zuverlässigkeit. Mit optimierten Prompts und neueren Modellen steigt die Übereinstimmung mit menschlichen Bewertungen weiter. Abweichungen treten vor allem bei neutralen Aussagen auf — einem Bereich, in dem auch menschliche Beurteilungen häufig divergieren. Daraus leiten wir ein neues Konzept ab: den Human-AI-Gap-Benchmark. KI-Performance sollte nicht an einer Fehlerquote von null gemessen werden, sondern im Verhältnis zur menschlichen Fehlerquote.

Rechtliche Einordnung: EU AI Act

Sentiment-Analyse ist trotz ihrer Zuverlässigkeit ein Black-Box-Prozess mit eingeschränkter Erklärbarkeit. Wir haben die Methode auf Konformität mit dem EU AI Act geprüft — ob sie unter Medical AI oder verbotene Emotionserkennung fällt. Unsere Lösung: Sentiment-Ergebnisse werden anonym gespeichert, der Chat-Verlauf wird unmittelbar nach dem Gespräch gelöscht.

Fazit

KI-gestützte Sentiment-Analyse ist praxistauglich und präzise genug für den Einsatz im Hochschulkontext. Im SMARTA-Projekt wird sie als vertrauenswürdiges Modul eingesetzt — ein weiterer Schritt zu einer KI, die nicht nur antwortet, sondern wirklich versteht.

→ Zum vollständigen Paper auf ResearchGate